2026 年 09 月 19 日
Reward AI 深度调研报告
#AI 总结
从斯坦福 DexCap / Mobile ALOHA 谱系长出来的「跨本体机器人基础模型」
官网 · https://www.rewardai.com/
一级技术文档 · OM-1: Frontier Robot Intelligence, Learned Firsthand from Humans(2026-09-14)
About us(CEO 署名) · https://www.rewardai.com/about/
官方演示视频 · https://youtu.be/IJvyS2aPsnA | 官方 X @RewardAI_ | YouTube @reward-ai
00结论先行
1. 公司画像。Reward AI 是一家 2025 年成立、2026-09-14 走出隐身的旧金山湾区机器人基础模型公司,由两位斯坦福博士 Zipeng Fu(CEO,中文名多译作付梓鹏 / 符梓鹏) 与 Chen Wang(CTO) 联合创立。官方旁证
2. 技术主张一句话。把机器人学习的数据入口从「机器人本体」前移到「人手」:用一套自研 7 自由度可穿戴采集设备 Omnibody Hand 把人类自然操作录成多模态流,训出跨本体的通用策略 OM-1,再用仿真强化学习训练的高频控制层去消化不同机器的动力学差异——即官方口号 One Model, One Data Interface, Any Body。官方
3. 它是 UMI → DexCap 谱系的工业化升级版。UMI 的核心机制是「同一个手持夹爪,人戴着采、机器人装上跑」;Reward AI 把夹爪换成「同一个 7-DoF 功能手 + 触觉/接近/力 + 电磁追踪」,并显式拆出一个独立时钟的控制层。CEO 本人是 UMI on Legs(CoRL 2024)的合著者,CTO 是 DexCap(RSS 2024)一作。旁证·技术溯源
4. 目前唯一可验证的硬指标,是采集端的追踪误差(高速段平均过冲 24.9 mm → 9.5 mm,降 60%)。任务成功率、数据规模、模型参数量、推理频率、融资金额、客户名单——全部未披露。官方旁证
5. 商业化尚未真正开始,但方向已经写在脸上。无定价、无客户、无 API、无开源;创始人反复强调「Efficiency is ROI」与「所有视频均为 1 倍速」,明确对标产线节拍与部署回报,并强调模型可以「直接落到客户厂房里已经站着的机器人上」。官方推断
01公司速览
| 项目 | 内容 | 性质 |
|---|---|---|
| 公司名 | Reward AI(品牌与 X 账号均写作 Reward AI,官网域名 rewardai.com) | 官方 |
| 成立时间 | 2025(LinkedIn 公司页);两位创始人分别于 2025 年前后完成斯坦福博士 | 官方 |
| 地理位置 | San Francisco Bay Area(第三方媒体口径,官网未标注地址) | 旁证 |
| 规模 | 11–50 人(LinkedIn 公司页);Privately Held | 官方 |
| 定位自述 | 「engineers, company builders and researchers … spanning the full stack: from large foundation models to gearboxes, from hands to legs, from visual and tactile perception to high-frequency control」 | 官方 |
| 首个产品 | OM-1(Omnibody Model 1)通用机器人策略 + Omnibody 全栈(Omnibody Hand / One Data Interface / Control Any Body) | 官方 |
| 融资 | 未披露金额、轮次、投资方。第三方行业通讯明确指出「截至本次发布,官网尚未披露融资金额和投资方」 | 旁证 |
| 开放程度 | 模型权重、代码、数据集、API 均不开放;无论文发表 | 旁证 |
| 联系方式 | general@rewardai.com(商务)、careers@rewardai.com(招聘) | 官方 |
02信息来源清单
调研共梳理出 49 条信息源,按性质分为三类。下表是按类别汇总的骨架。
| 类别 | 条数 | 代表来源 | 在本报告中的作用 |
|---|---|---|---|
| 官方 | 15 | 官网首页 / About us(CEO 署名)/ Blog 索引 / OM-1 技术博文 / 官方演示视频 / 官方 X @RewardAI_ / 官方 YouTube @reward-ai / LinkedIn 公司页 / Zipeng Fu 首发帖 / 两位创始人个人主页与 CV | 事实基线。但需注意:所有性能声明均为「公司自述」,尚无第三方复现 |
| 旁证 | 31 | DexCap / Mobile ALOHA / HumanPlus / DeepWBC / UMI on Legs / UMI / Sequential Dexterity / MimicPlay / SwingBot 等论文与项目页;Humanoids Daily、RuntimeWire、Digital CxO、CIVL、humanoid.guide、腾讯新闻·机器人前瞻、网易、SOURCEMIND、alphaXiv、Lacuna | 技术脉络溯源 + 交叉验证 + 竞争定位。媒体报道中区分「事实转述」与「作者评论」 |
| 推断 | 3 | 基于官网 About 页「Selected past work by our team」14 张图的作者反查;基于「不开源 + 无客户 + Efficiency is ROI」的商业化路径判断 | 补充官方未披露的信息。均标注推理链条,与官方事实分开表述 |
官网 About 页有一栏 「Selected past work by our team」,是一组滚动图片。它的正文文本在页面上不可见,但每张图片的 alt 属性是可读的官方文本——这是目前唯一能推断「除两位创始人之外还有谁」的官方线索。本报告第三节的团队推断即基于此。
同理,OM-1 博文中 9 段演示视频的 aria-label 也是官方文本,其中一条直接写明:「Omnibody Hands in motion, on robot arms and worn by a person at a table」——这是判断「同一只手既戴在人手上、也装在机器人上」的官方证据。官方
03核心成员:背景与代表性优势
3.1 Zipeng Fu(付梓鹏 / 符梓鹏)· 联合创始人 & CEO
- 本科
- UCLA,计算机科学 + 应用数学双学士(2016–2020),师从 Song-Chun Zhu(朱松纯)
- 硕士 / 研究
- CMU 机器学习硕士 + 机器人研究所(Robotics Institute)研究生研究员(2020-08–2022-06),师从 Deepak Pathak 与 Jitendra Malik
- 博士
- Stanford AI Lab 计算机科学博士(2022-09 起),导师 Chelsea Finn,2.5 年完成;获 Pierre and Christine Lamond Fellowship(CS 系 top 7)
- 大厂 / 产业
- Google DeepMind 学生研究员(2023-06–2023-12,与 Jie Tan 合作,做机器人导航大模型);Vayu Robotics 实习(2022-07–09)
官方 个人主页 zipengfu.github.io 与其 CV;旁证 alphaXiv 档案补充 Vayu Robotics 经历
博士期间及之前的工作:一条「从底层自适应到系统可部署」的完整链
| 代表作 | 时间 / 会议 | 做了什么 | 沉淀的能力 |
|---|---|---|---|
| RMA: Rapid Motor Adaptation | RSS 2021 (CMU 硕士期) |
让四足机器人在未知地形上通过在线自适应快速恢复运动能力;被 WSJ、Forbes、DARPA 等广泛报道 | 底层鲁棒控制 + 在线自适应 |
| Deep Whole-Body Control | CoRL 2022 Oral · Best Systems Finalist |
用一个统一策略同时解决「操纵」与「移动」,即四足/轮式底盘 + 机械臂的全身控制 | 全身控制(WBC)的系统化 |
| Robot Parkour Learning | CoRL 2023 Oral · Best Systems Finalist |
四足机器人跑酷:在复杂地形上做感知驱动的敏捷运动 | 感知—控制 tight coupling |
| UMI on Legs | CoRL 2024 | 把 UMI(手持夹爪采集)学到的操纵策略,通过「以操纵为中心的全身控制器」装到移动底盘上 | 直接参与 UMI 谱系:理解「采集—策略—控制」三段如何咬合 |
| Mobile ALOHA(共同一作) | CoRL 2024 | 低成本(约 3.2 万美元)双臂移动操纵系统;炒虾、开柜、按电梯、冲洗锅具;软硬件全开源,全球刷屏 | 系统级工程 + 大规模影响力 |
| HumanPlus(共同一作) | CoRL 2024 Best Paper Finalist(top 6) |
人形机器人通过第一视角「影随」人体动作学习,再从人类动作做模仿学习 | 人形本体 + 人类动作到机器人的迁移 |
| Mobility VLA / Open X-Embodiment | CoRL 2024 / ICRA 2024(Best Paper) | 导航大模型;跨本体数据集与 RT-X 模型(DeepMind 主导的协作) | 大模型范式 + 跨本体数据标准 |
他的核心能力不是「提出新算法」,而是「把学习到的策略真正部署到开放世界」。从 RMA(让控制器在未知地形不崩)、DeepWBC(把移动与操纵合成一个策略)、Robot Parkour(把感知与控制耦合到极限)、到 Mobile ALOHA / HumanPlus(做成可复现、可开源、可演示的完整系统),这条线的每一步都在回答同一个问题:怎样让一个 learned policy 在真实机器、真实节拍下不失效。
这直接解释了 OM-1 的架构选择:为什么「控制层」是一等公民——独立高频时钟、仿真 RL 训练、在线优化相邻预测过渡。这不是一个做 VLA 的人会优先设计的东西,而是一个做了四年「deployable robot systems」的人会优先设计的东西。推断(基于其论文序列与 OM-1 架构的一致性)
次要但关键的一点:他是 UMI on Legs 的合著者,对 UMI 这条「用同一套手持硬件消解具身鸿沟」的路线有一手经验。这解释了为什么 Reward AI 敢把「同一个 Omnibody Hand 既戴在人手上、也装在机器人上」作为跨本体机制。旁证
3.2 Chen Wang · 联合创始人 & CTO
- 本科
- 上海交通大学 计算机科学学士,师从 卢策吾(Cewu Lu)
- 博士
- Stanford 计算机科学博士(2020 起,2025-06 毕业),师从 李飞飞(Li Fei-Fei) 与 C. Karen Liu
- 研究经历
- MIT CSAIL(2019,Edward Adelson GelSight 触觉组)→ NVIDIA Research(2022,NVIDIA Graduate Fellowship Finalist)→ Google DeepMind(2024)
- 研究方向自述
- 「robot learning for dexterous manipulation, imitation learning from human motion, and long-horizon planning and control」
官方 个人主页 chenwangjeremy.net
博士期间及之前的工作:一条极度聚焦的「人类动作 → 机器人动作」线
| 代表作 | 时间 / 会议 | 做了什么 | 沉淀的能力 |
|---|---|---|---|
| DenseFusion / 6-PACK / 力-扭矩动力学 | CVPR 2019 ICRA 2020 IROS 2019 |
6D 物体姿态估计(RGB-D 稠密融合、类别级关键点跟踪);peg-in-hole 的可迁移力-扭矩动力学模型 | 接触与力的建模(本科阶段已切入) |
| SwingBot | IROS 2020 Best Paper Award |
用手内触觉探索学习物体物理特征,完成动态摆甩操纵(MIT GelSight 组) | 触觉驱动的动态操纵 |
| Co-GAIL / HAN / robomimic | CoRL 2021 IROS 2021 |
从人人协作示范中抽取协作策略;手眼协调的动作空间;robomimic 大规模模仿学习基准 | 模仿学习基础设施 |
| MimicPlay(一作) | CoRL 2023 Oral · 三项 Finalist |
从「人类自由玩耍」的视频中提取 latent plan,指导低层机器人策略,大幅减少对机器人本体示教的依赖 | 用廉价人类数据换昂贵机器人数据 |
| Sequential Dexterity(共一) | CoRL 2023 | 把多个多指手策略「链接」起来完成长程操纵,无需重新抓取即可切换功能模式 | 多指灵巧 + 长程组合 |
| VoxPoser / ReKep / TRANSIC / Obj-Dex | CoRL 2023–2024 | 用大模型合成 3D value map;关系关键点约束做时空推理;sim2real 在线纠正;从人类动作数据做物体中心灵巧操作 | 高层规划 + 落地纠正 |
| DexCap(一作) | RSS 2024 | 便携式手部动捕系统:胸前相机架(RGB-D LiDAR + 3 台 SLAM 相机)+ 电磁场动捕手套 + 背包计算/供电(约 40 分钟);采人类灵巧操作 → fingertip IK 重定向到 LEAP 灵巧手 → 点云 Diffusion Policy | Omnibody Hand 的直接前身 |
他整个博士在做同一件事:降低「人类示教 → 机器人执行」的转换成本。Co-GAIL(从人人协作示范学)→ MimicPlay(从人玩的视频学 latent plan)→ Sequential Dexterity(多指策略链接)→ DexCap(便携设备直接采人手)→ Obj-Dex(人类动作数据直接训物体中心灵巧操作)。这条线没有任何一步是「顺便做的」,每一步都在削薄同一个瓶颈。
第二层优势是传感侧的完整度:他在 MIT GelSight 组做过纯触觉驱动的操纵(SwingBot,IROS 2020 最佳论文),又在本科阶段做过力-扭矩动力学建模。Omnibody Hand 上「触觉 + 指间接近 + 力 + 手内相机」这套多模态组合,几乎是他人生的技术简历直接硬件化了。推断
词组证据:官方博文明确写 「Building on our prior work DexCap …」;创始人在首发帖中也写 「We build on our prior work DexCap at Stanford.」官方
3.3 创始人之外的团队:基于官方 past-work 图谱的推断
官网没有 team 页,LinkedIn 公司页只显示 Zipeng Fu 一个具名成员 + 5 个匿名头像。About 页的「Selected past work by our team」是唯一官方线索,共 14 张图。把图片 alt 文本与各论文/项目逐一反查,可以得到下表。除标注为官方/旁证的行外,人员身份均为推断。
| past-work 图(官方 alt 摘要) | 对应工作 | 已知作者 | 性质 |
|---|---|---|---|
| 双臂机器人在灶台炒虾 | Mobile ALOHA(CoRL 2024) | Zipeng Fu(共一) | 官方 |
| 人形叠卫衣 / 系鞋带 | HumanPlus(CoRL 2024) | Zipeng Fu(共一) | 官方 |
| 两只灵巧手用剪刀剪胶带 | DexCap(RSS 2024) | Chen Wang(一作) | 官方 |
| 机器人手拼装积木 | Sequential Dexterity(CoRL 2023) | Chen Wang(共一) | 官方 |
| 机械臂操作意式咖啡机 | VIOLA(CoRL 2022) | Yifeng Zhu 等(UT Austin) | 推断 |
| 夹爪装穹顶光学触觉指尖 | DenseTact(ICRA 2022) | Won Kyung Do、Monroe Kennedy III(Stanford ARMLab) | 推断 |
| 四足+机械臂在草地俯身 | Deep Whole-Body Control(CoRL 2022) | Zipeng Fu(共一) | 官方 |
| 小型人形爬木台阶 | ToddlerBot(arXiv 2502.00893) | Haochen Shi、Weizhuo Wang(二人同时也是 DexCap 共同作者) | 推断(置信度较高) |
| Science Robotics 封面:四足跨过倒木 | 腿足 locomotion 代表作 | 大概率即 Robot Parkour Learning(Zipeng Fu 共一) | 旁证 |
| 移动操纵器从桌面拿起苹果 | GDM / Meta 机器人工作 | 大厂机器人研究背景成员 | 推断 |
| Falcon 9 双助推器同步着陆 | 航天工程背景 | 疑似有 SpaceX 经历的硬件/工程成员 | 推断 |
| 3D 打印摆线针轮减速器剖开 | 自研传动 | 机械/硬件工程成员 | 推断 |
About 页原文:「We are engineers, builders and researchers who pioneered robot learning in dexterous manipulation, mobile manipulation, and legged locomotion, spanning the full stack: from large foundation models to gearboxes, from hands to legs, from visual and tactile perception to high-frequency control.」官方
即官方宣称同时具备:大模型(foundation models)— 减速器齿轮箱(gearboxes,硬件传动)— 手(hands,灵巧操作)— 腿(legs,腿足运动)— 视觉与触觉感知 — 高频控制。这与上表反查出的「VIOLA / DenseTact / ToddlerBot / 摆线减速器 / Falcon 9」构成相互印证。推断
04技术路线:软硬一体的 Omnibody 栈
4.1 全景架构
4.2 数据采集方式:Omnibody Hand
硬件设计取舍:功能灵巧 ≠ 逐关节仿人
官方明确反对两条路:一是「脆弱的 20+ 自由度逐关节复刻人手」,二是「平行夹爪」。Omnibody Hand 走中间:一个紧凑的 7 自由度设计,只保留对操纵真正重要的功能。
| 设计要素 | 官方表述 |
|---|---|
| 精细捏取 | 采集拇指-食指对捏,同时记录拇指与食指屈曲,使拇指既能配合食指也能配合其余手指 |
| 力量抓握 | 中指、无名指、小指在掌指关节(MCP)联动,配合拇指屈曲包覆物体 |
| 手内重定向 | 在手中调整物体姿态(in-hand reorientation)被列为三大优先项之一 |
| 人体工学不变性 | 集成的远端屈曲机构吸收指长差异,降低对关节对位的敏感度,免除 per-user 连杆调整。官方理由:佩戴不适会让人改变抓法,而「被补偿过的抓法不再是我们要记录的行为」 |
| 传感通道 | 全局快门手内相机(图像)、高频触觉、指间接近传感、力、手部位姿轨迹 |
| 追踪方案 | 视觉-惯性 + 电磁(EM)传感增强,并有算法补偿环境电磁扰动 |
唯一公开的量化指标
UMI 谱系定位:这是你最关心的一节
Reward AI 没有在官方材料中提「UMI」二字,但从硬件、动作表征到延迟处理,Omnibody Hand 与 UMI 是同一设计范式的迭代。下表把三代设备并排。
| 维度 | UMI(RSS 2024) | DexCap(RSS 2024) | Omnibody Hand(2026) |
|---|---|---|---|
| 形态 | 3D 打印手持平行夹爪 + GoPro | 胸前相机架(RGB-D LiDAR + 3 台 SLAM 相机)+ 电磁动捕手套 + 背包电源 | 7-DoF 可穿戴功能手(一体式) |
| 末端自由度 | 2-DoF 夹爪(仅开合宽度) | 手指 3D 位置(相对手掌,EMF 测) | 7-DoF:拇指/食指独立屈曲 + 中/无名/小指 MCP 联动 |
| 追踪 | GoPro + IMU-aware SLAM(改进 ORB-SLAM3) | SLAM 相机 + 电磁场 | 视觉-惯性 + 电磁(EM) + 环境电磁扰动补偿 |
| 视觉 | 155° 鱼眼 + 双侧镜「隐式立体」 | 胸前 RGB-D | 全局快门手内相机(快速运动下保持视觉上下文) |
| 接触 / 力 | 无(仅有夹爪宽度本体感知) | 无(纯位置) | 触觉 + 指间接近 + 力 |
| 动作表征 | 相对轨迹(相对当前夹爪位姿) | 指尖 IK → LEAP 手 16 维关节位置 | 运动方向 / 速度 / 力 / 事件时序(本体无关) |
| 跨本体机制 | 要求「平行夹爪行程 > 85 mm」,免标定 | 需为每个目标手做 fingertip IK 重定向;用 FK 生成机器人手点云补进观测以弥合视觉鸿沟 | 不做数据级重定向,交给仿真 RL 控制层吸收 |
| 采集效率 | 约 3× teleoperation | 约 3× teleoperation,接近自然人类速度 | 未披露(但按人类自然节拍,无需放慢) |
| 代表作式 demo | 动态抛掷 87.5%、洗碗 70%、野外泛化 71.7% | 30 分钟人类 mocap 数据学会新任务,无需遥操作 | <30 分钟学会含挑战动力学的长程新任务 |
继承(5 条):
- 同一套硬件,人戴着采、机器人装上跑。这一条有官方直接证据——OM-1 博文视频
aria-label原文:「Omnibody Hands in motion, on robot arms and worn by a person at a table」,另有「An Omnibody Hand on a robot arm unscrewing a braided hose fitting」「Two robot arms with Omnibody Hands gripping either side of a cable connector」。官方 - 便携、in-the-wild、脱离机器人采集。
- 以手部/腕部相机为观测中心(UMI 是腕上 GoPro,Omnibody 是手内全局快门相机)。
- 本体无关的「相对 / 功能」动作表征。
- 显式处理延迟(UMI 做推理时 latency matching;Reward 升级为独立时钟控制层)。
改造(4 条,也是 Reward 声称的差异点):
- 平行夹爪 → 7-DoF 功能手。官方直指 UMI 类方案的软肋:「平行夹爪能解决很多任务,但通常是通过约束接近方向、接触位置与操纵策略来实现的」。对应 Humanoids Daily 的评述:2-DoF 夹爪「人为限制了接近角与接触点」。官方旁证
- 纯视觉 SLAM → 视觉-惯性 + 电磁。理由:视觉更新率限制了跟随快速反向运动的能力,常见补救是事后平滑轨迹或要求人放慢——两者都会破坏「就是要采快速伸手与细微修正」这个目标。官方
- 补上触觉 / 接近 / 力。补齐纯视觉推断不出的「接触、力、时序」这一层物理信息。
- 延迟处理从「对齐」升级为「解耦」。UMI 做的是推理时的观测—动作延迟匹配;Reward 让控制层跑在自己的高频时钟上,并在线优化相邻两次预测的过渡,使推理延迟的抖动完全不打断运动。
谱系可证性:Zipeng Fu 是 UMI on Legs(CoRL 2024)合著者,Chen Wang 是 DexCap 一作——两位创始人分别站在 UMI 分支与 DexCap 分支上,Omnibody Hand 是这两条线的合流。旁证·技术溯源
4.3 数据标注方式:官方口径是「根本不需要标注」
这是 OM-1 与主流路线最不相同的一点,值得拆开看。
| 标注环节 | 传统做法 | OM-1 的做法 | 性质 |
|---|---|---|---|
| 动作标签 | 遥操作采集 → 记录机器人关节/末端状态 → 需按本体动作空间对齐 | 标签是传感器内生的:位姿轨迹(追踪)、接触与接近(触觉/接近传感)、力(力传感)、事件时序(抓取/释放,由接触+力信号判定) | 官方 |
| 动作重定向 | DexCap 需 fingertip IK 把人手映射到 LEAP 手;UMI 需按本体夹爪行程过滤 | 官方声称没有数据级重定向:OM-1 直接「从人类运动生成机器人动作」,本体差异交给控制层 | 官方 |
| 视觉域适配 | DexCap 用 FK 生成机器人手点云叠加进点云观测,弥合人—机视觉鸿沟 | 未披露类似机制(推测被「同一只 Omnibody Hand 也装在机器人上」这一设计绕过) | 推断 |
| 数据分桶 | pre-training / post-training 分阶段,每阶段可能需要不同标注与筛选 | 无分界:所有演示经同一接口以同一格式进入,「第一条演示与最新一条演示训同一个策略」 | 官方 |
| 场景组织 | staged 实验室场景、专人监督采集 | 官方:无需 staged setup、无人监督,「工作、玩、做饭、或只是过一天」都在产出数据 | 官方 |
| 质量纠正 | DexCap 提供 human-in-the-loop 纠正(residual correction 等) | 未见提及;取而代之的是「涌现的重试/补偿/停止」行为 | 旁证 |
官方把「标注」描述为零成本,但工程上它更可能是被转移到了另外两处,而这两处官方都未披露:推断
- 采集设备侧:多传感器时空标定、不同佩戴者的一致性、电磁环境扰动补偿——这些是 One Data Interface 的隐性成本,也是 Omnibody Hand 必须自研的原因。
- 控制层侧:要「零样本落到任意本体」,就必须为每种目标本体建立足够好的动力学模型与域随机化,并在仿真里训练 RL 控制器。每接入一个新本体,仍有工程量,只是从「重新采一遍数据 + 重新训策略」变成了「训练一个控制层」。
换句话说:Reward 把成本从「数据端·随任务线性增长」搬到了「硬件端·一次性投入 + 控制端·随本体种类增长」。这个置换是否划算,取决于他们能覆盖多少种本体——而这正是目前完全看不到数字的地方。
4.4 模型 OM-1 与控制层
| 模块 | 公开的技术要点 | 性质 |
|---|---|---|
| 输入模态 | 图像(场景上下文)、触觉信号(接触与滑动)、指间接近(接触前状态)、手部位姿轨迹;并消费这些流的时间历史 | 官方 |
| 采样率处理 | 按各传感器的原生采样率处理,不统一下采样到相机帧率——保住高频触觉与运动线索 | 官方 |
| 输出动作 | 运动方向、速度、力、关键事件(抓取/移动)的时序 | 官方 |
| 训练范式 | 单阶段;无 pre-training / post-training 切分;扩展靠「增加人类数据」而非「为每种机器人设计新训练阶段」 | 官方 |
| 架构 | 「为高效推理定制的新架构」(未披露任何细节:参数量、backbone、是否 Transformer/Diffusion 均未说明) | 官方 |
| 控制层 | 仿真中 RL 训练;处理与速度/加速度相关的动力学、外部扰动、系统延迟;独立高频时钟;在线优化相邻两次预测的过渡 | 官方 |
| 覆盖能力 | 不只桌面操纵,还包括全身工作(支撑、倾身、踏入任务)以及移动机器人的导航 | 官方 |
| 效率主张 | <30 分钟人类演示数据学会全新任务(含挑战动力学、长程);长程任务执行 <30 秒(1× 速度) | 官方 |
| 涌现行为 | 一臂失误另一臂自动补偿;知道何时重试;能适应对抗性扰动;环境变化过大时主动停止 | 官方 |
4.5 已公开的 Milestone(演示清单)
截至 2026-09-19,官方共公开 9 段演示视频(OM-1 博文内嵌,720p/60fps,画面左上角统一带官方「Fully autonomous, 1x speed」水印)与 1 段发布合集。下列任务名直接取自官方 aria-label 与视频文件名。每个任务配 GIF 预览(由官方 mp4 转制)。
从官方 9 个 mp4 文件直接读到真实时长:最短 9.9 s(cross-embodiment),最长 158.6 s(iphone-long)。其中 laundry 原片 16.5 s,与官方文案「约 17 秒」吻合——说明视频长度≈单次任务时长。由此得到一个官方未说明的观察:官方口径是「长程任务执行 < 30 秒(1× 速度)」,但 ethernet-unplug(107.8 s)与 iphone-long(158.6 s)远超 30 秒,二者应包含多次重试或连续多循环作业,而非单次任务。推断
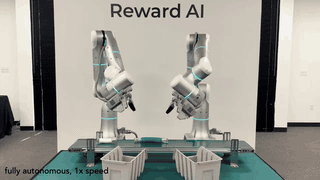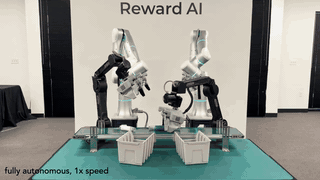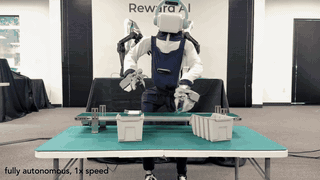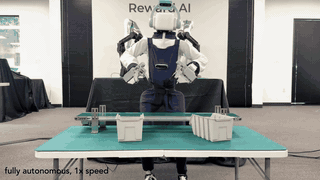
人形机器人与一对工业臂都装了 Omnibody Hand,在同一策略下把传送带上的物品分拣入箱。
Omnibody Hand 运动特写——同一只手既装在机器人臂上,也被演示者戴在手上。这是「人戴采集、机装执行」同构主张最直接的画面证据。
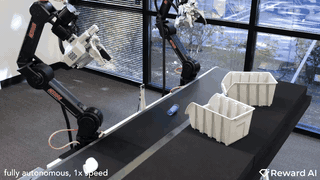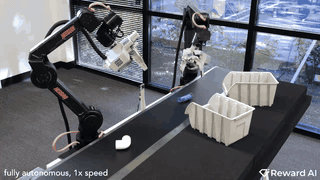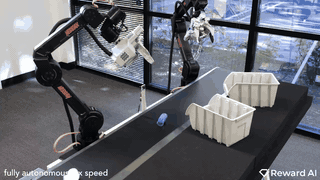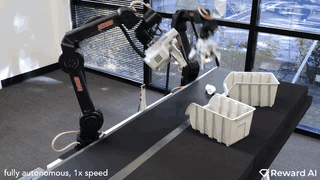
两只机械臂从移动传送带上抓取物体并抛入料箱。
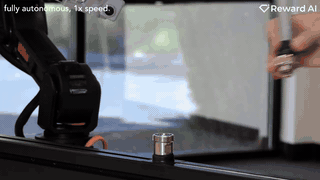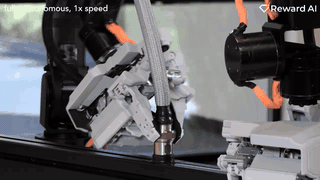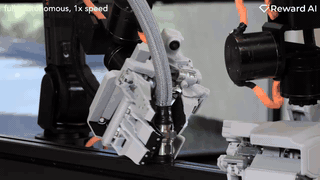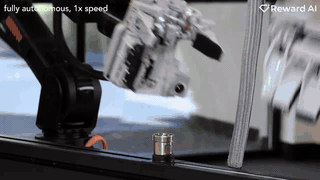
装在机械臂上的 Omnibody Hand 在传送带上方拧开编织软管接头,另一臂扶稳组件。
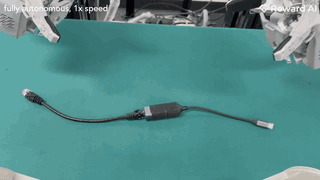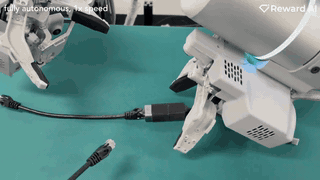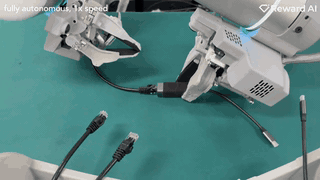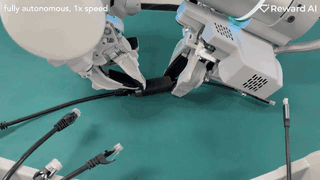
两臂用 Omnibody Hand 抓住连接器两侧并拔开;需极精确按压卡扣才能释放。被创始人点名为「deceptively hard」。
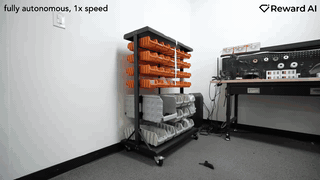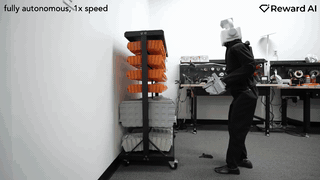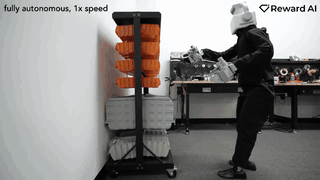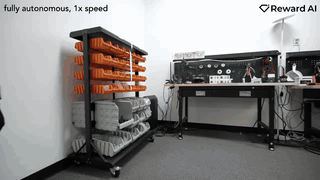
人形机器人从料架取件并抛掷一旁。
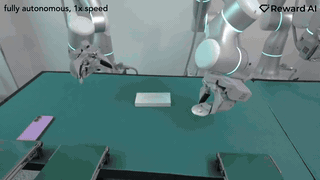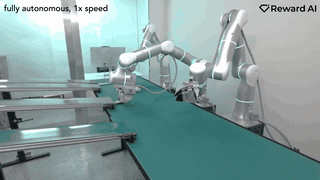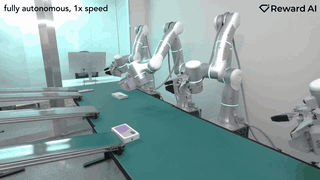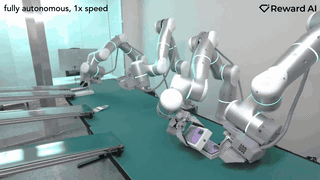
手机包装长程任务,发布中展示四臂协同(quadmanual)。是 9 段视频中时长最长的一段。
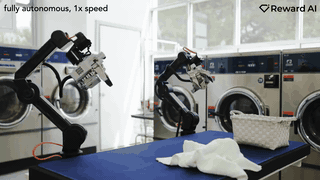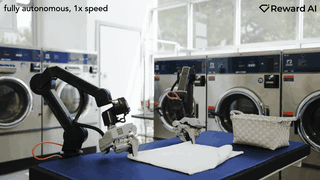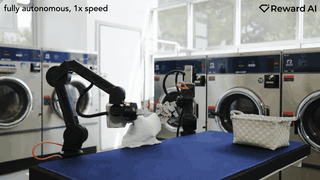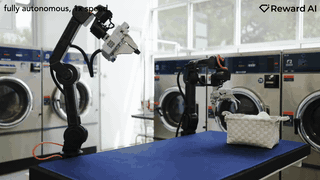
两臂在洗衣店折叠床单。原片 16.5 s 与官方文案「约 17 秒」一致,是唯一可交叉验证时长的演示。
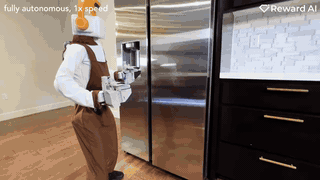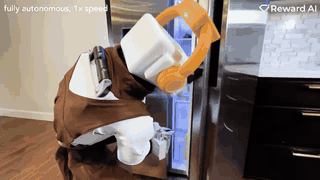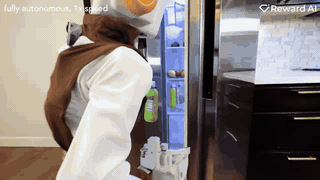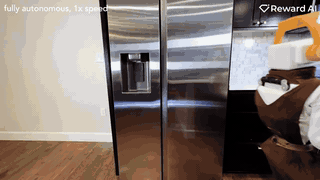
人形拉开完全关闭的不锈钢冰箱门并伸手取饮料。
倒酒液、加冰、摇壶、拔瓶塞、倒入杯中,一次性完成。该片段出现在官方发布视频中,官网博文未提供独立 mp4,故无 GIF。
- 来源:全部取自官网博文的官方 mp4 直链(
/blog/OM-1/videos/*-720-h264-labeled.mp4),未做任何裁剪或变速。 - 转制:ffmpeg 降采样至宽 320 px、96 色、4.5–7 fps。因此 GIF 比原片卡顿,不代表官方帧率;原片为 60 fps。
- 节选说明:
sorting-2、ethernet-unplug、iphone-long三段因原片过长(26 s / 107.8 s / 158.6 s),GIF 采用均匀抽样的多片段拼接,非连续播放。其余 6 段为完整时长。 - 保真度:GIF 保留了原片的水印与「labeled」标注层,可作为官方「1× 速度」主张的原始证据。
- 体积:9 个 GIF 合计约 12 MB,单个 0.7–1.8 MB,均已启用懒加载;单个文件均 < 2 MB,可直接用于微信公众号动图(上限 10 MB)。
- 原始 mp4 与官方视频:全部 9 个 mp4 已本地留存;完整发布合集见 YouTube 官方视频。
4.6 时间线
05商业化战略与现状
5.1 现状:可以确认的事实
| 维度 | 状态 | 性质 |
|---|---|---|
| 融资 | 完全未披露——金额、轮次、投资方均无。第三方行业通讯明确指出「截至本次发布,Reward 的官网尚未披露融资金额和投资方」 | 旁证 |
| 客户 / 部署 | 未披露任何客户名、部署数量或试点 | 旁证 |
| 定价 / 时间表 | 无商业化时间表、无定价 | 旁证 |
| 开放策略 | 模型权重、代码、数据集、API 全部内部保留;无论文发表;官方要求引用形式为「blog article」 | 旁证 |
| 团队规模 | 11–50 人;招聘邮箱 careers@rewardai.com 在官网显著位置 | 官方 |
| 本体合作 | 公开材料中未点名本体厂商。有一条待核实的第三方线索指向 Flexiv(非夕)Rizon 臂参与过演示,未能二次核实 | 推断·待核实 |
5.2 战略信号:从官方措辞里读出来的东西
| 官方表述(原文) | 解读 | 性质 |
|---|---|---|
| 「Efficiency is ROI. ROI is what gets robots deployed.」 | 把「效率」直接定义成投资回报。这不是研究者的措辞,是卖给工厂的措辞 | 官方 |
| 「If other models look faster, check the corner of the frame: 2x, sometimes 5x.」 | 主动挑起「速度造假」议题,把 1× 原速做成品牌资产。攻击性定位 | 官方 |
| 「Every clip we publish runs at 1x speed, clearly labeled.」 | 同上,写进了 About 页的方法论部分,不是临时公关话术 | 官方 |
| 「can be dropped onto whatever robots already stand on a customer's floor」 | 不卖本体。目标客户是已经买了机器人的工厂 / 集成商 —— 存量设备升级,而不是卖新硬件 | 官方 |
| 「A robot earns its place in a factory, a kitchen, or a warehouse …」 | 目标场景:工厂、厨房、仓库。与演示任务(3C 包装、传送带分拣、折衣、调酒)一致 | 官方 |
| 「beginning with quadmanual manipulation … extending to mixed teams」 | 多机协作是差异化叙事:瞄准「单臂干不了的活」(搬家具、大件装配、高峰期厨房) | 官方 |
| 「demonstrations we collect today will still be training robot bodies that haven't been designed yet」 | 数据资产论:数据不随硬件换代贬值,而是升值。这是给投资人和客户的双重叙事 | 官方 |
5.3 商业化路径推断
大概率路径:B2B,向已有机器人存量的客户提供「策略 + 控制层」的部署/授权,同时可能出租或销售 Omnibody Hand 采集设备用于客户现场采任务数据。推理链条:
- 不开源、无 API → 排除了「做社区标准/生态平台」的路子,价值捕获必须发生在交付环节。
- 「drop onto whatever robots already stand on a customer's floor」→ 明确不造本体,因此收入不可能靠硬件整机,只能靠软件能力 + 采集设备。
- 「Efficiency is ROI」+ 反复强调节拍 → 卖点是替代人工的每小时产出,计价方式很可能是按部署站点/机器人数量,而非按 token 或按模型调用。
- 招聘邮箱置顶 + 11–50 人规模 + 刚走出隐身 → 处于「建交付能力」而非「建销售网络」的阶段,近期更可能是少数深度试点而非广铺。
核心壁垒判断:不是模型本身,而是「采集设备—数据接口—控制层」这条闭环。任何一环缺了,跨本体就退化成普通 VLA。这也意味着:他们的护城河高度依赖 Omnibody Hand 的可制造性与成本——而这恰恰是公开信息里最薄的一环。
5.4 竞争格局定位
| 路线 | 代表公司 | 数据入口 | 性质 |
|---|---|---|---|
| 人手可穿戴采集 (Reward 所在) |
Reward AI | 7-DoF 功能手 + 触觉/接近/力 + EM 追踪;功能性中间路线——比 2-DoF 表达力强,比 20+ DoF 同构更解耦 | 官方旁证 |
| 同上 · 最贴近的对手 | Sunday Robotics (Tony Zhao + Cheng Chi) |
Skill Capture Glove:更简单的 2-DoF 平行夹爪式;强调手套与自研 Memo 机器人手的几何与传感器对应;主攻家务(折衣) | 旁证 |
| 严格同构路线 | X Square Robot(深圳) | TwinDEX:9-DoF 外骨骼,通过与配套三指机器人手严格物理同构来消除具身鸿沟 | 旁证 |
| 互联网视频预训练 | Dyna Robotics(Dyna-2) Rhoda AI(DVA) |
海量网络/人类视频预训练 + 任务数据后训练。Rhoda 报告最大模型 100 秒内无人介入完成率 84.7% | 旁证 |
| VLA / 基础模型 | Physical Intelligence(π0) Gemini Robotics 1.5 / 2 Skild AI(S1)、Generalist(GEN-1.5) |
开放机器人数据集 + 遥操作 + 合成数据混合。Gemini Robotics 2 称可用数小时、通常 <200 个样本适配新双臂机器人 | 旁证 |
| 数据基础设施 | XDOF(GELLO 系)、Mecka AI | 把采集/清洗/标注/质控外包成服务;XDOF 6 月披露 7000 万美元融资并开源 ABC-130K(13 万条双臂轨迹 / 195 类任务) | 旁证 |
06关键风险与待验证清单
- 所有性能指标均为公司自测。唯一可量化的数字(24.9 → 9.5 mm)测的是采集端追踪误差,不是任务成功率。第三方(Humanoids Daily、humanoid.guide)均明确指出:无大规模成功率数据、无论文、无开源。旁证
- 「Any Body」的边界需要澄清。官方视频
aria-label显示,跨本体演示中的人形与工业臂都装了 Omnibody Hand。若「零样本跨本体」的前提是本体必须装上同一只手,那么它的适用范围与「随便什么机器人即插即用」之间存在口径差。这是本报告认为最值得向官方追问的一点。官方素材推断 - 无第三方复现路径。权重、代码、数据集、API 全不开放,外界无法独立验证。旁证
- 融资不透明。无金额、无投资方,无法评估 runway 与可获得算力。在一个「算力即壁垒」的赛道里,这是重大信息缺口。旁证
- 「<30 分钟」容易被误读。第三方通讯特别澄清:这指的是演示数据量,不是端到端训练耗时。旁证
- 长期运行稳定性未验证。行业对标的是「99.9% uptime」,而实验室演示与产线连续运行之间还有很长的路——这也是 Skild AI 等公司公开挑战「demo culture」的核心论点。旁证
- 采集设备的规模化未验证。Omnibody Hand 集成了 7-DoF 机构、触觉阵列、接近传感、全局快门相机、EM 追踪——它的成本、良率、耐用性、标定流程,是整条路线能否规模化的物理瓶颈,而官方对此零披露。推断
未来 3–12 个月观察清单
- 是否发布论文或完整技术报告(当前引用形式仍是 blog article)
- 是否给出标准化成功率与失败案例(而非仅演示视频)
- 是否出现第三方测试、客户部署或试点披露
- 是否披露融资金额与投资方
- 是否开放 API / 权重 / 数据集
- quadmanual 多机协作与人形全身操作 + 导航的后续进展(官方已预告 "More on this later")
- Omnibody Hand 是否会单独对外(销售/租赁/开源硬件)
07附录:核心信息源速查
| # | 来源 | URL | 性质 |
|---|---|---|---|
| S04 | OM-1 技术博文(一级来源) | rewardai.com/blog/OM-1/ | 官方 |
| S02 | About us(CEO 署名) | rewardai.com/about/ | 官方 |
| S11 | Zipeng Fu 首发帖 | LinkedIn · zipengfu | 官方 |
| S12 | Zipeng Fu 个人主页 / CV | zipengfu.github.io | 官方 |
| S14 | Chen Wang 个人主页 | chenwangjeremy.net | 官方 |
| S16 | DexCap(RSS 2024)项目页 | dex-cap.github.io | 旁证 |
| S24 | UMI(RSS 2024)项目页 | umi-gripper.github.io | 旁证 |
| S35 | Humanoids Daily · 走出隐身报道 | humanoidsdaily.com | 旁证 |
| S36 | RuntimeWire · OM-1 发布 | runtimewire.com | 旁证 |
| S42 | 腾讯新闻 · Mobile ALOHA 作者新模型 | new.qq.com | 旁证 |
| S44 | SOURCEMIND · 北美具身公司名单 | 行业通讯(明确指出融资未披露) | 旁证 |